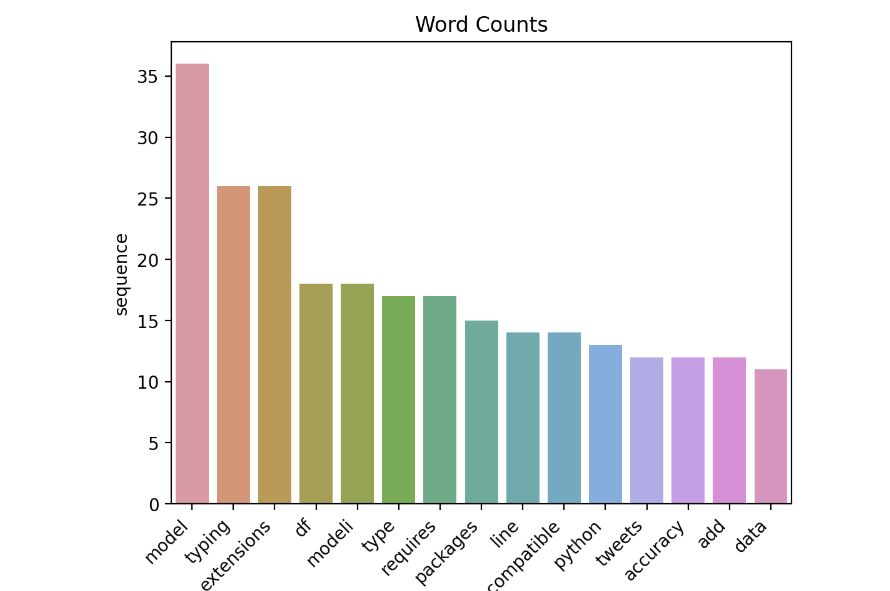
Frequentie: 36 — het kernbegrip dat door elk onderwerpcluster loopt.
← Case studies
Onderzoek · NLP
Diepgaande NLP-analyse
Een pipeline voor taalanalyse op corpusniveau — van ruwe termfrequentie en woordverdeling tot het ontdekken van latente onderwerpen met LDA — gebouwd als basis voor de retrieval- en inhoudsbegriplaag van Learning Matrix.
- Methode
- LDA-topicmodellering
- Tooling
- pyLDAvis · NLTK · gensim
- Resultaat
- 20+ gevonden onderwerpen
- Toegepast in
- Learning Matrix
Overzicht
Begrijpen wat leerlingen echt vragen — en hoe die vragen clusteren — is de basis van betrouwbare onderwijs-AI. Deze analyse neemt een technisch vraag-en-antwoordcorpus, brengt het terug tot het signaal en modelleert de latente onderwerpstructuur, zodat de retrievallaag antwoorden met semantisch inzicht kan ophalen, rangschikken en uitleggen.
De pipeline heeft drie fasen: corpusstatistiek om de verdeling van termen te begrijpen, LDA-topicmodellering om latente thema's te vinden, en interactieve verkenning om de samenhang van onderwerpen te toetsen voordat het model in de productieretrieval wordt opgenomen.
Stap 01
Corpusstatistiek
Ruwe termfrequentie en woordenschatverdeling — vaststellen welke tokens signaal dragen en welke vóór het modelleren gefilterd moeten worden.
Dominante termmodel
Signaal in de woordenschatML / NLP
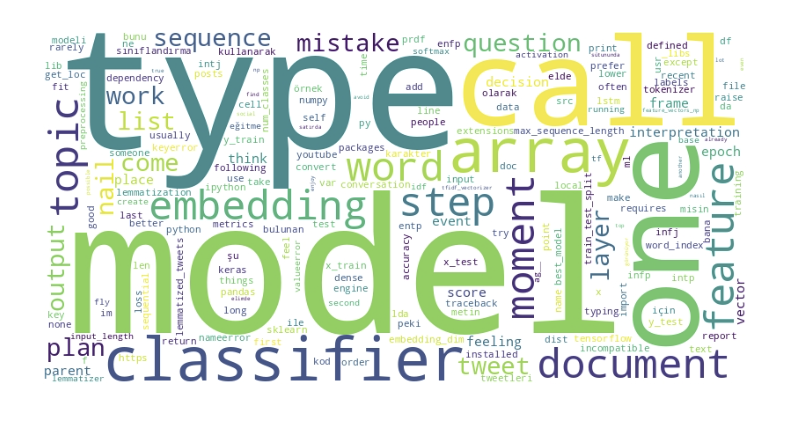
Het corpus is technisch dicht: embedding, classifier, sequence en feature komen op grote schaal samen voor.
VoorbewerkingGelemmatiseerd
Stopwoorden verwijderd, tokens in kleine letters en gelemmatiseerd vóór de LDA-input.
Stap 02
LDA-topicmodellering
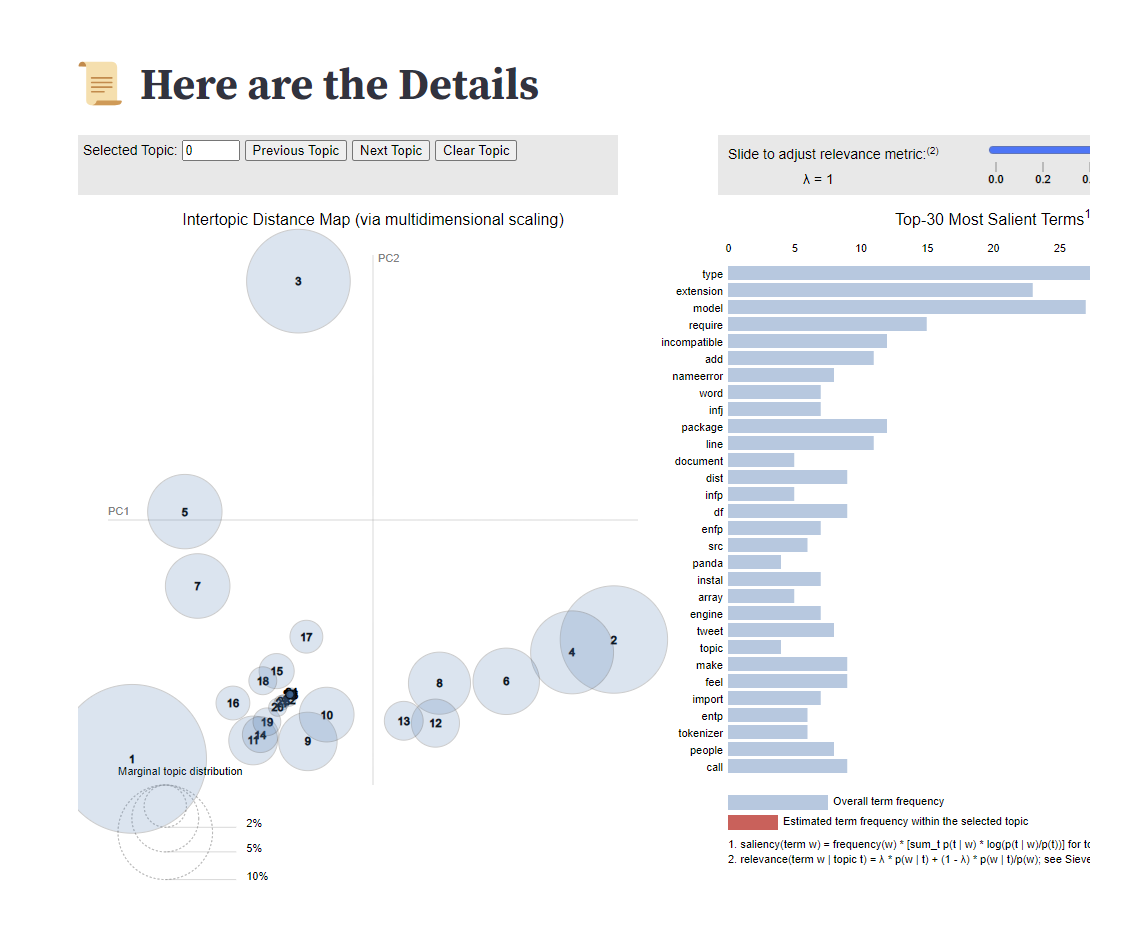
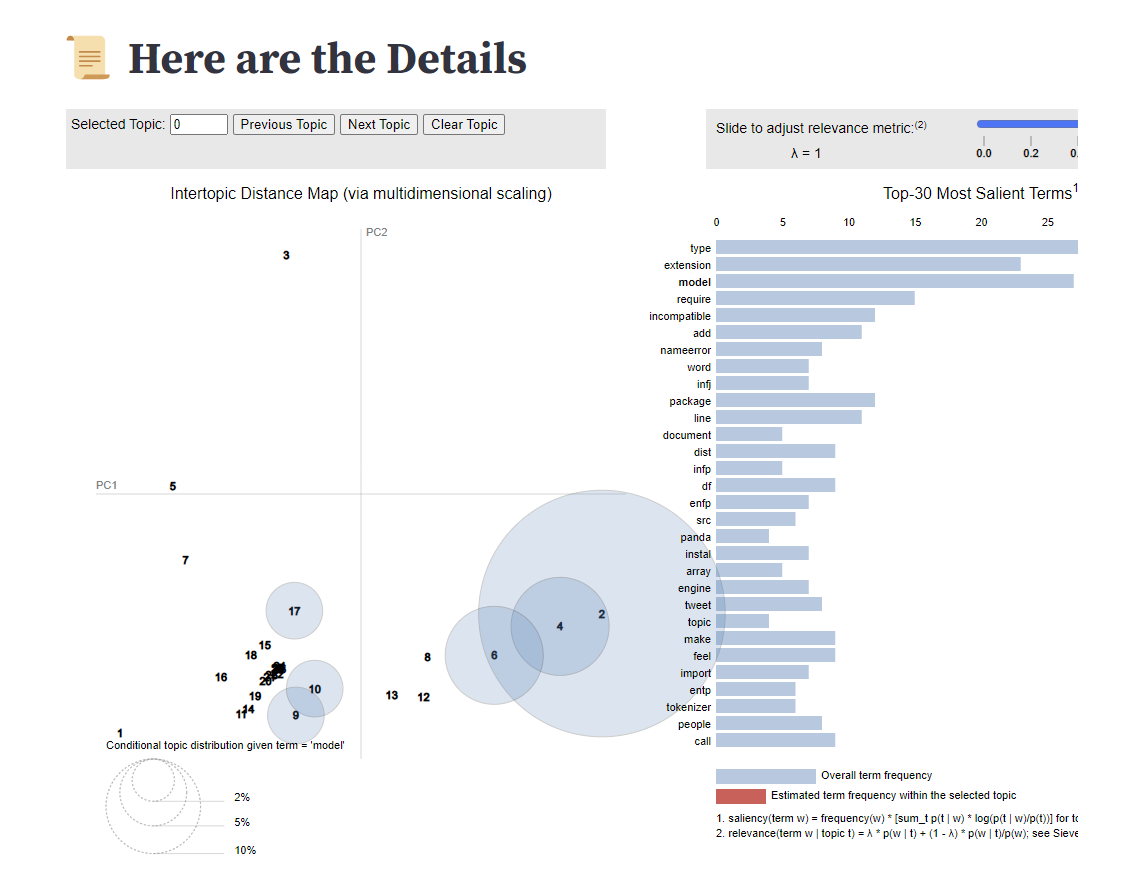
Latent Dirichlet Allocation over het opgeschoonde corpus — 20+ samenhangende onderwerpen gevonden, met hun scheiding en termsaliëntie gevisualiseerd in pyLDAvis.
Gevonden onderwerpen20+
Afzonderlijke latente thema's uit het corpus.
Scheiding van onderwerpenGoed
Onderwerpen 1–4 zijn groot en overlappen niet; dichtere clusters in onderwerpen 9–20.
Relevantiemaat (λ)Instelbaar
λ = 0 toont termen die uniek zijn voor een onderwerp; λ = 1 weegt de totale frequentie.
Stack & methoden
PythongensimNLTKLDApyLDAvismatplotlibWordCloudElasticsearchRAG